Líneas de investigación

IA Inclusiva y Sostenible: Nuevas Dimensiones en la Colaboración Centrada en la Persona

AI con una mano

La línea de investigación propuesta se centra en el desarrollo de tecnología basada en Inteligencia Artificial (IA) y Modelos de Lenguaje de Gran Tamaño (LLM) bajo una perspectiva inclusiva y sostenible, buscando avanzar en cómo estas tecnologías pueden mejoradas junto con la interacción humano-computadora (HCI). Esta línea aborda varios aspectos clave como:

  • Accesibilidad e Inclusión: Investigación dedicada a la creación de sistemas de IA y LLM que sean universalmente accesibles, con un enfoque particular en tecnologías adaptativas que puedan ser utilizadas por personas con diversas capacidades, incluidas aquellas con discapacidad. Se exploran métodos para hacer la interacción con la IA más accesible y intuitiva para los usuarios menos experimentados.

  • Personalización y Contextualización: Desarrollo de modelos de IA y LLM que no solo generen lenguaje natural, sino que también sean capaces de adaptar sus respuestas y soluciones a las necesidades, preferencias y contextos específicos de los usuarios. Esto incluye la personalización de contenido, la adaptabilidad de las interfaces y la capacidad de interpretar las intenciones y emociones humanas de manera más precisa.

  • Sostenibilidad: Investigación sobre cómo hacer que la IA y los LLM sean más eficientes en términos de energía y recursos computacionales. Este enfoque busca un uso responsable y el minimizar la huella de carbono de las tecnologías de IA, desarrollando algoritmos que requieran menos potencia de cálculo y promoviendo prácticas de desarrollo sostenible dentro de la comunidad tecnológica.

  • Colaboración Humano-IA: Exploración de nuevos modelos de interacción entre humanos y sistemas de IA que vayan más allá de la asistencia para la resolución conjunta de problemas. Investigamos cómo las máquinas pueden actuar no solo como herramientas o asistentes, sino como colaboradores que potencian las capacidades humanas.
Accesibilidad Cognitiva [NLP, AI & HCI]

Logotipo de Proyecto EASIER

Investigación y desarrollo de tecnologías de Procesamiento de Lenguaje Natural (PLN) e Inteligencia Artificial (IA) para la simplificación de textos, con el objetivo de hacer el contenido textual más comprensible de manera sistemática y automática. Nuestro expertise se destaca especialmente en el trabajo con personas con limitaciones cognitivas, como pueden ser las personas con discapacidad intelectual y personas mayores, entre otros. Iniciamos nuestro trabajo empleando métodos más tradicionales de PLN, evolucionando hacia el uso de transformadores y, finalmente, a los Modelos de Lenguaje de Gran Tamaño (LLMs) que aplicamos hoy en día. Este progreso tecnológico nos ha permitido explorar y mejorar la simplificación de textos a través de métodos, lenguajes y recursos lingüísticos especializados. 

Abordamos distintos enfoques de simplificación en función del público objetivo, teniendo destacado expertise en la simplificación siguiendo dos iniciativas parecidas pero con diferencias, como son el Lenguaje Claro y las pautas de Lectura Fácil. Nuestros trabajos incluyen además la creación de corpus en el marco del Lenguaje Claro y la Lectura Fácil, adaptando soluciones a diversos dominios como administraciones públicas, educación y salud.

Además, investigamos tecnologías para apoyar a los profesionales en la adaptación de textos a Lectura Fácil y Lenguaje Claro, ofreciendo herramientas para la detección de palabras complejas, evaluación de legibilidad, generación de resúmenes, entre otras funcionalidades.

Un aspecto esencial en nuestras investigaciones es la validación constante con personas y el público objetivo de los trabajos realizados utilizando métodos de la Interacción Persona Ordenador (HCI), asegurando que nuestras soluciones no solo sean tecnológicamente avanzadas, sino también efectivamente útiles y accesibles para aquellos a quienes están destinadas.

Proyectos destacados:

  • EASIER
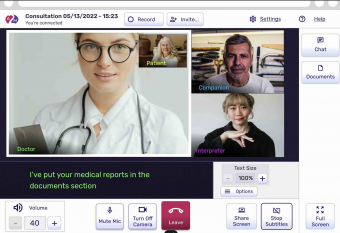
  • Accesibilidad cognitiva y sensorial a los sistemas de videoconferencia (Access2Meet)

Accesibilidad y UX a los Interfaces de Usuario con Discapacidad [HCI, NLP & IA]

Pantallazo de plataforma ACCESS2MEET

Investigación y desarrollo de tecnologías que soportan el diseño y desarrollo de interfaces de usuario accesibles (páginas web, apps, entre otros) optimizando la experiencia de usuario (UX). Contamos con amplia experiencia en tecnologías accesibles, asegurando que puedan ser accedidas y utilizadas por cualquier persona, incluidas aquellas con discapacidad. Parte de nuestra experiencia en accesibilidad y discapacidad se ha enriquecido por nuestra larga colaboración con el El Centro Español del Subtitulado y la Audiodescripción es un centro dependiente del Real Patronato sobre Discapacidad (Ministerio de Derechos Sociales y Agenda 2030) liderado por la Universidad Carlos III de Madrid. Nuestra experiencia abarca distintos tipos de discapacidad (visual, auditiva, física, intelectual y personas mayores), y, por lo tanto, en distintos tipos de accesibilidad (visual, auditiva, física, cognitiva) y en diversos dominios de aplicación.

Seguimos enfoques que combinan, por un lado, el desarrollo conforme a estándares y marcos reguladores esenciales a cumplir, y por otro lado, diseños centrados en las personas que permiten capturar aquellos requisitos de interacción no contemplados en los estándares, utilizando métodos de accesibilidad y HCI (Interacción Humano-Computadora).

Poseemos un amplio conocimiento en estándares de accesibilidad (UNE, ETSI, ISO), como las WCAG, UAAG, ATAG, COGA, EN 301 549, entre otros. Trabajamos con métodos de HCI más tradicionales, como los diseños centrados en el usuario, así como con enfoques de co-diseño, como el Design Thinking y el modelo del Doble Diamante.

Proyectos más destacados:

Tecnologías Avanzadas de Accesibilidad en la Educación

Niños en aula con tablets

Esta linea se centra en el desarrollo e implementación de soluciones tecnológicas avanzadas para superar las barreras de comunicación y acceso a la información que enfrentan las personas con discapacidades, especialmente en entornos educativos. 

Se busca no solo facilitar el acceso a materiales de aprendizaje digital de manera inclusiva, sino también mejorar la experiencia educativa global a través de la integración de servicios de subtitulado, audiodescripción, y lengua de signos adaptados a las necesidades de estudiantes con discapacidad auditiva y visual. Parte de nuestra experiencia en accesibilidad y discapacidad se ha enriquecido por nuestra larga colaboración con el El Centro Español del Subtitulado y la Audiodescripción es un centro dependiente del Real Patronato sobre Discapacidad (Ministerio de Derechos Sociales y Agenda 2030) liderado por la Universidad Carlos III de Madrid.

Esta línea de investigación aborda el reto de crear entornos de aprendizaje accesibles y usables, aplicando técnicas de reconocimiento automático de voz, procesamiento de lenguaje natural y otras tecnologías de inteligencia artificial, con el fin de producir contenidos educativos accesibles y de alta calidad. 

Proyectos más destacados: PICOGAC, Access2Class

Tecnologías del Lenguaje Natural: Reconocimiento de entidades nombradas y de expresiones temporales

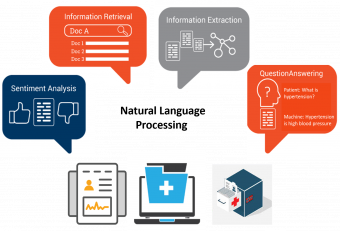
natural language processing image

La extracción de entidades nombradas (NERC por Named Entity Recognition and Classification) es una rama del área de la Extracción de Información, cuyo objetivo consiste en identificar unidades de información en el texto y clasificarlas en categorías previamente definidas, tales como personas, organizaciones, lugares, etc. 
Internet y las tecnologías de la Web 2.0 han propiciado una  explosión de la información disponible en diferentes modalidades y las técnicas de Extracción de Información son una de las alternativas para organizar y mejorar el acceso a este torrente de información. En los últimos años han aparecido varios servicios software comercial que permiten la extracción de palabras claves y de Entidades Nombradas (NE del inglés Named Entity). Estos servicios se han integrado en numerosas aplicaciones y es previsible que, con el avance del software como servicio, sirvan para mejorar las capacidades semánticas y de interoperabilidad de muchas más en un futuro próximo. 
En el grupo investigamos en algoritmos adaptables a distintos dominio e idiomas para reconocimiento de entidades utilizando técnicas de boostrapping cuando no se dispone de recursos específicos como diccionarios, analizadores, etc.      

Por otro lado, en la actualidad, muchas de las aplicaciones para el Procesamiento de Lenguaje Natural (PLN) que conocemos podrían obtener una mejora sustancial en su rendimiento si contemplaran el tratamiento de la dimensión temporal que tiene la información que manejan. Un claro ejemplo de esta afirmación se da en el campo de la Recuperación de Información (RI): los principales motores comerciales de búsqueda en Web no realizan un análisis explícito de la información temporal de los contenidos, o lo hacen de una manera superficial, desaprovechando la semántica subyacente y su potencial para implementar técnicas avanzadas de ordenación de información, selección y filtro de resultados, etc.
La información temporal permite localizar los eventos de un texto en una línea temporal obteniendo un orden cronológico. Una persona puede extraer de manera implícita todas las expresiones temporales de un texto y la relación que éstas establecen entre los eventos, interpretando el punto del tiempo al que se refiere dicha expresión. Sin embargo, cuando se trata de interpretar grandes cantidades de información nos enfrentamos a una tarea demasiado costosa para realizarla de manera manual. Si se trata de automatizar este proceso, es preciso dotar de conocimiento adicional a los sistemas que vayan a realizar el razonamiento.

Por ello, trabajamos en la definición, desarrollo y evaluación de una propuesta para el tratamiento automático de la información temporal que es habitualmente manejada por las aplicaciones de acceso a la información no estructurada. Asimismo, se busca investigar en mecanismos de representación de la semántica temporal de los documentos que tratan dichas aplicaciones, con el fin de mejorar la recuperación de la información relevante. Para su consecución se hace preciso el análisis tanto en el nivel de formulación de las necesidades de información que los usuarios plantean a este tipo de sistemas, como en el de extracción de la información que éstos proporcionan como respuesta. Dicha propuesta contará con capacidades adicionales de gestión temporal con respecto a los sistemas tradicionales de acceso a la información, proporcionando una nueva perspectiva de explotación del tiempo y salvando así algunos de los problemas existentes.       

Natural Language Processing (NLP) and Big Data Analysis in the Health Sector.

image of doctor and patient

This research line focuses on developing and applying advanced NLP techniques and deep learning algorithms for extracting, analysing, and utilising clinical information in unstructured electronic health records (EHRs). I

t aims to transform large volumes of textual data into structured and processable information, with the goal of improving clinical practice, supporting personalized medical decision-making, and facilitating research, especially in epidemiological studies that require the review and analysis of a large number of clinical records.

This approach not only promises significant optimization of resources and time in medical research but also adaptability to various clinical contexts and pathologies, underscoring the versatility and transformative potential of NLP and deep learning technologies in the health field.

Most notable projects: 

  • Clinical Information Extraction Using Deep Learning and Big Data Techniques (DeepEMR)

ANTECEDENTES

vista de pantalla de ordandor con codigo

Nuestras líneas de investigación reflejan el camino recorrido desde nuestros inicios, demostrando cómo las bases establecidas en áreas como el procesamiento del lenguaje natural , la biomedicina, el desarrollo web, y la accesibildiad han evolucionado hacia las actuales lineas vanguardistas.

Este recorrido muestra nuestra adaptabilidad y crecimiento sino que también fundamenta nuestras investigaciones presentes. Estas líneas de investigación, que siguen estado presentes son la siguientes:

Extracción y Recuperación de Información en el Dominio Biomédico

Investigación y desarrollo de herramientas automáticas para gestionar el crecimiento exponencial de datos y publicaciones biomédicas, facilitando la extracción de conocimientos valiosos para profesionales del sector.

Marcos Metodológicos para el Desarrollo de Aplicaciones Web Accesibles

Creación y pautas de aplicación de aplicaciones y sitios web accesible mediante el soporte metodológico AWA, destinado a integrar la accesibilidad como un requisito esencial en el desarrollo web.

Accesibilidad en el Entorno Educativo

Investigación y desarrollo de tecnologías de Información y Comunicación (TIC) pueden superar las barreras de accesibilidad en el e-Learning y los sistemas de gestión de contenidos educativos, promoviendo una educación inclusiva para todos.

Sistemas de Búsqueda de Respuestas

Investigación y desarrollo de Sistemas de Búsqueda de Respuestas (SBR) que permiten obtener información precisa a través de preguntas en lenguaje natural, abordando desafíos. 

Reconocimiento de Entidades Nombradas y de Expresiones Temporales

Investigación en el reconocimiento y clasificación de entidades nombradas y el tratamiento automático de información temporal en textos, para mejorar el rendimiento de aplicaciones de Procesamiento de Lenguaje Natural.

Modelado Conceptual, Restricciones de Integridad y Reglas del Negocio

Investigación en modelos de datos para mejorar la gestión, adaptabilidad y integración de sistemas de información, garantizando la exactitud y completitud de las bases de datos.